

Сайт занимает высокие позиции в Google, а в ответах нейросетей появляются конкуренты? Противоречия здесь нет. AI-поиск подбирает источники для конкретного объяснения, и место в обычной выдаче не гарантирует ссылку. Для бизнеса это еще одна точка контакта с клиентом, которую легко упустить. Вместе с Еленой Салтыковой, тимлидом команды SEO Wunder Digital, разбираемся, откуда AI-системы берут информацию и что мешает им использовать материалы ваших страниц.
Как AI находит информацию для ответов
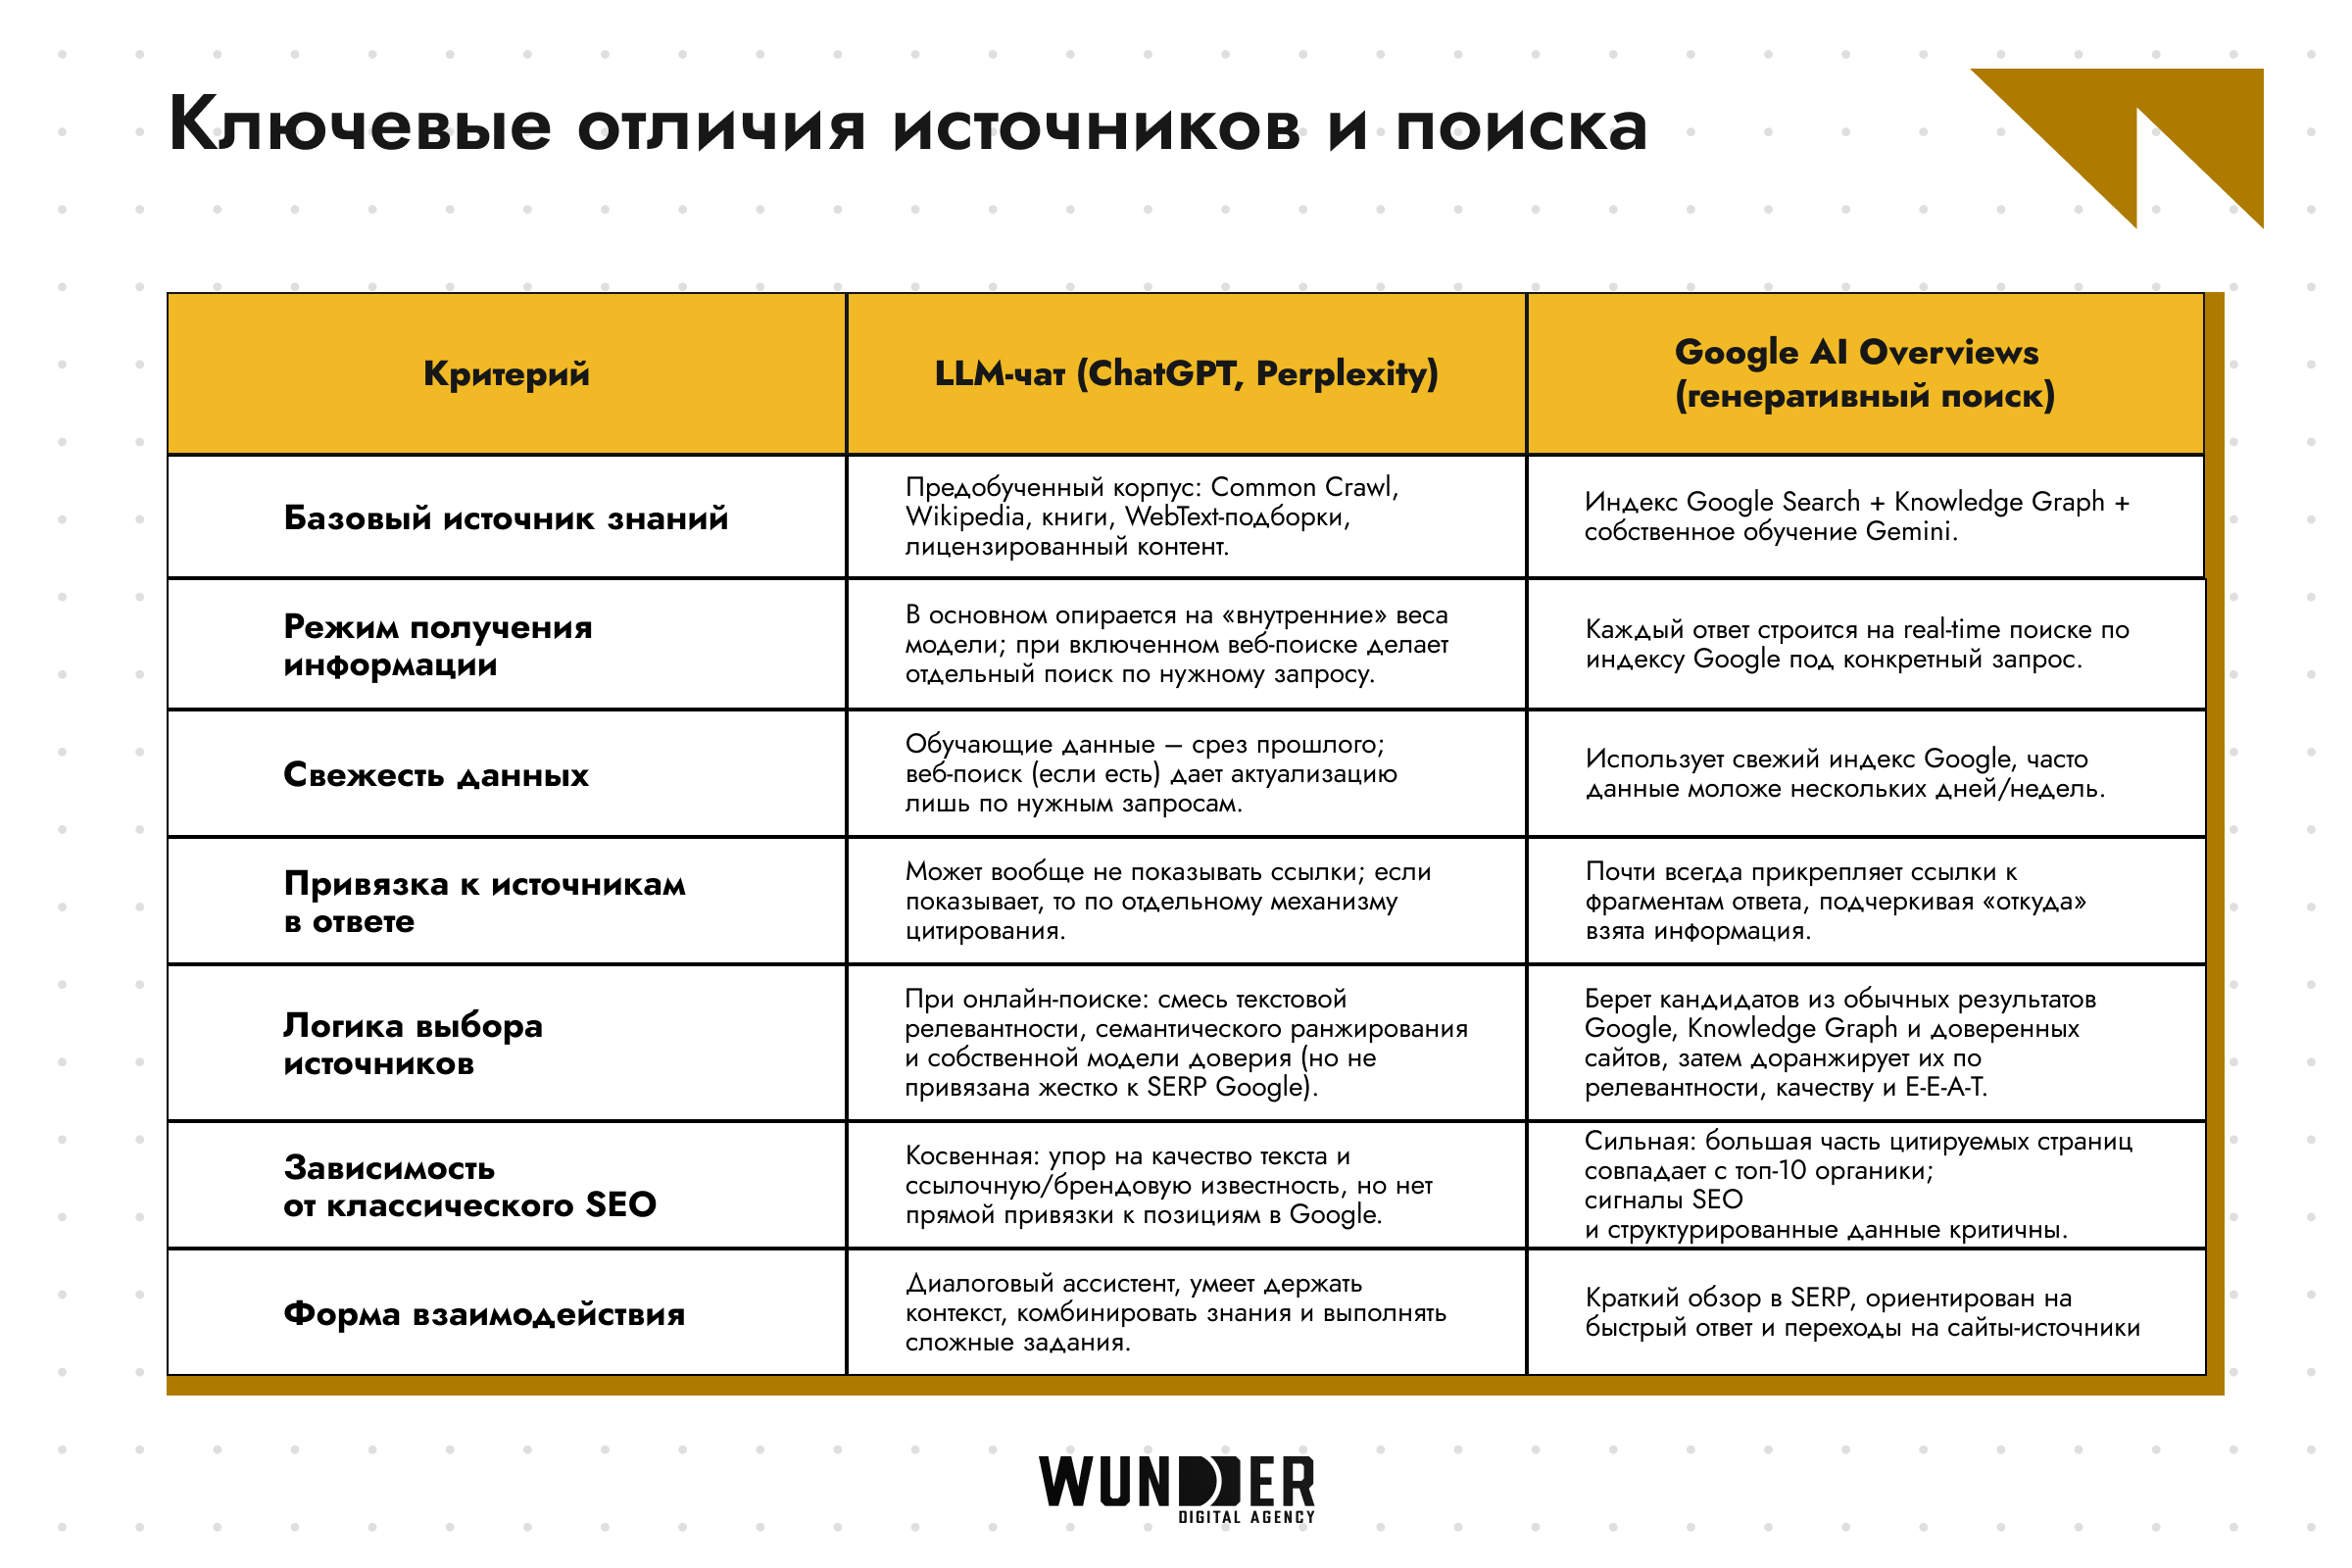
Чтобы понять, как попасть в ChatGPT, важно разобраться в источниках данных. Оценка сайта в SEO отличается от работы нейросети с его содержанием. Кроме того, ChatGPT, Gemini и Claude получают информацию разными способами.
Ответ может опираться на три группы данных.
1. То, что усвоено при обучении
Перед выпуском модель проходит обучение на обширном массиве публичных текстов. В него включают статьи и книги, материалы с форумов и открытых веб-страниц, техническую документацию. Так осваиваются статистические закономерности языка, факты и взаимосвязи.
2. Поиск свежих сведений в интернете
Чат-модели последних версий могут искать в сети свежие новости, данные о погоде и валютных курсах. Для этого служит встроенный поиск или интеграция с поисковиком. Найденное дополняет сведения, усвоенные при обучении.
3. Материалы, которые предоставляет пользователь
Модель также получает материалы от пользователя: таблицы, документы PDF и DOCX либо подключенную базу знаний, например через RAG. Для того ассистента, которому предоставлены эти данные, они становятся локальным источником.
Елена Салтыкова, тимлид команды SEO Wunder Digital:
— Ответ ChatGPT опирается на усвоенное при обучении или на результаты внешнего поиска, если он включен. Обращение к определенному сайту не происходит при каждом запросе. Повлияет ли ваш материал на ответ, зависит от его качества и авторитетности источника.
У похожих публикаций больше шансов оказаться в обучающих данных или среди результатов онлайн-поиска, если контент цитируют, у него развит ссылочный профиль и сильны составляющие E-E-A-T: опыт, экспертиза, авторитетность и доверие.
У моделей есть ограничения:
- содержимое закрытых баз данных им недоступно;
- личные данные пользователей они не видят;
- конкретные статьи и сайты не сохраняются в их памяти;
- самостоятельного обновления знаний не происходит.
Первоисточник отдельного факта модели неизвестен. На основе обучения она выстраивает логичный ответ, который выглядит как можно правдоподобнее.

По какому принципу Google подбирает источники для AI Overviews
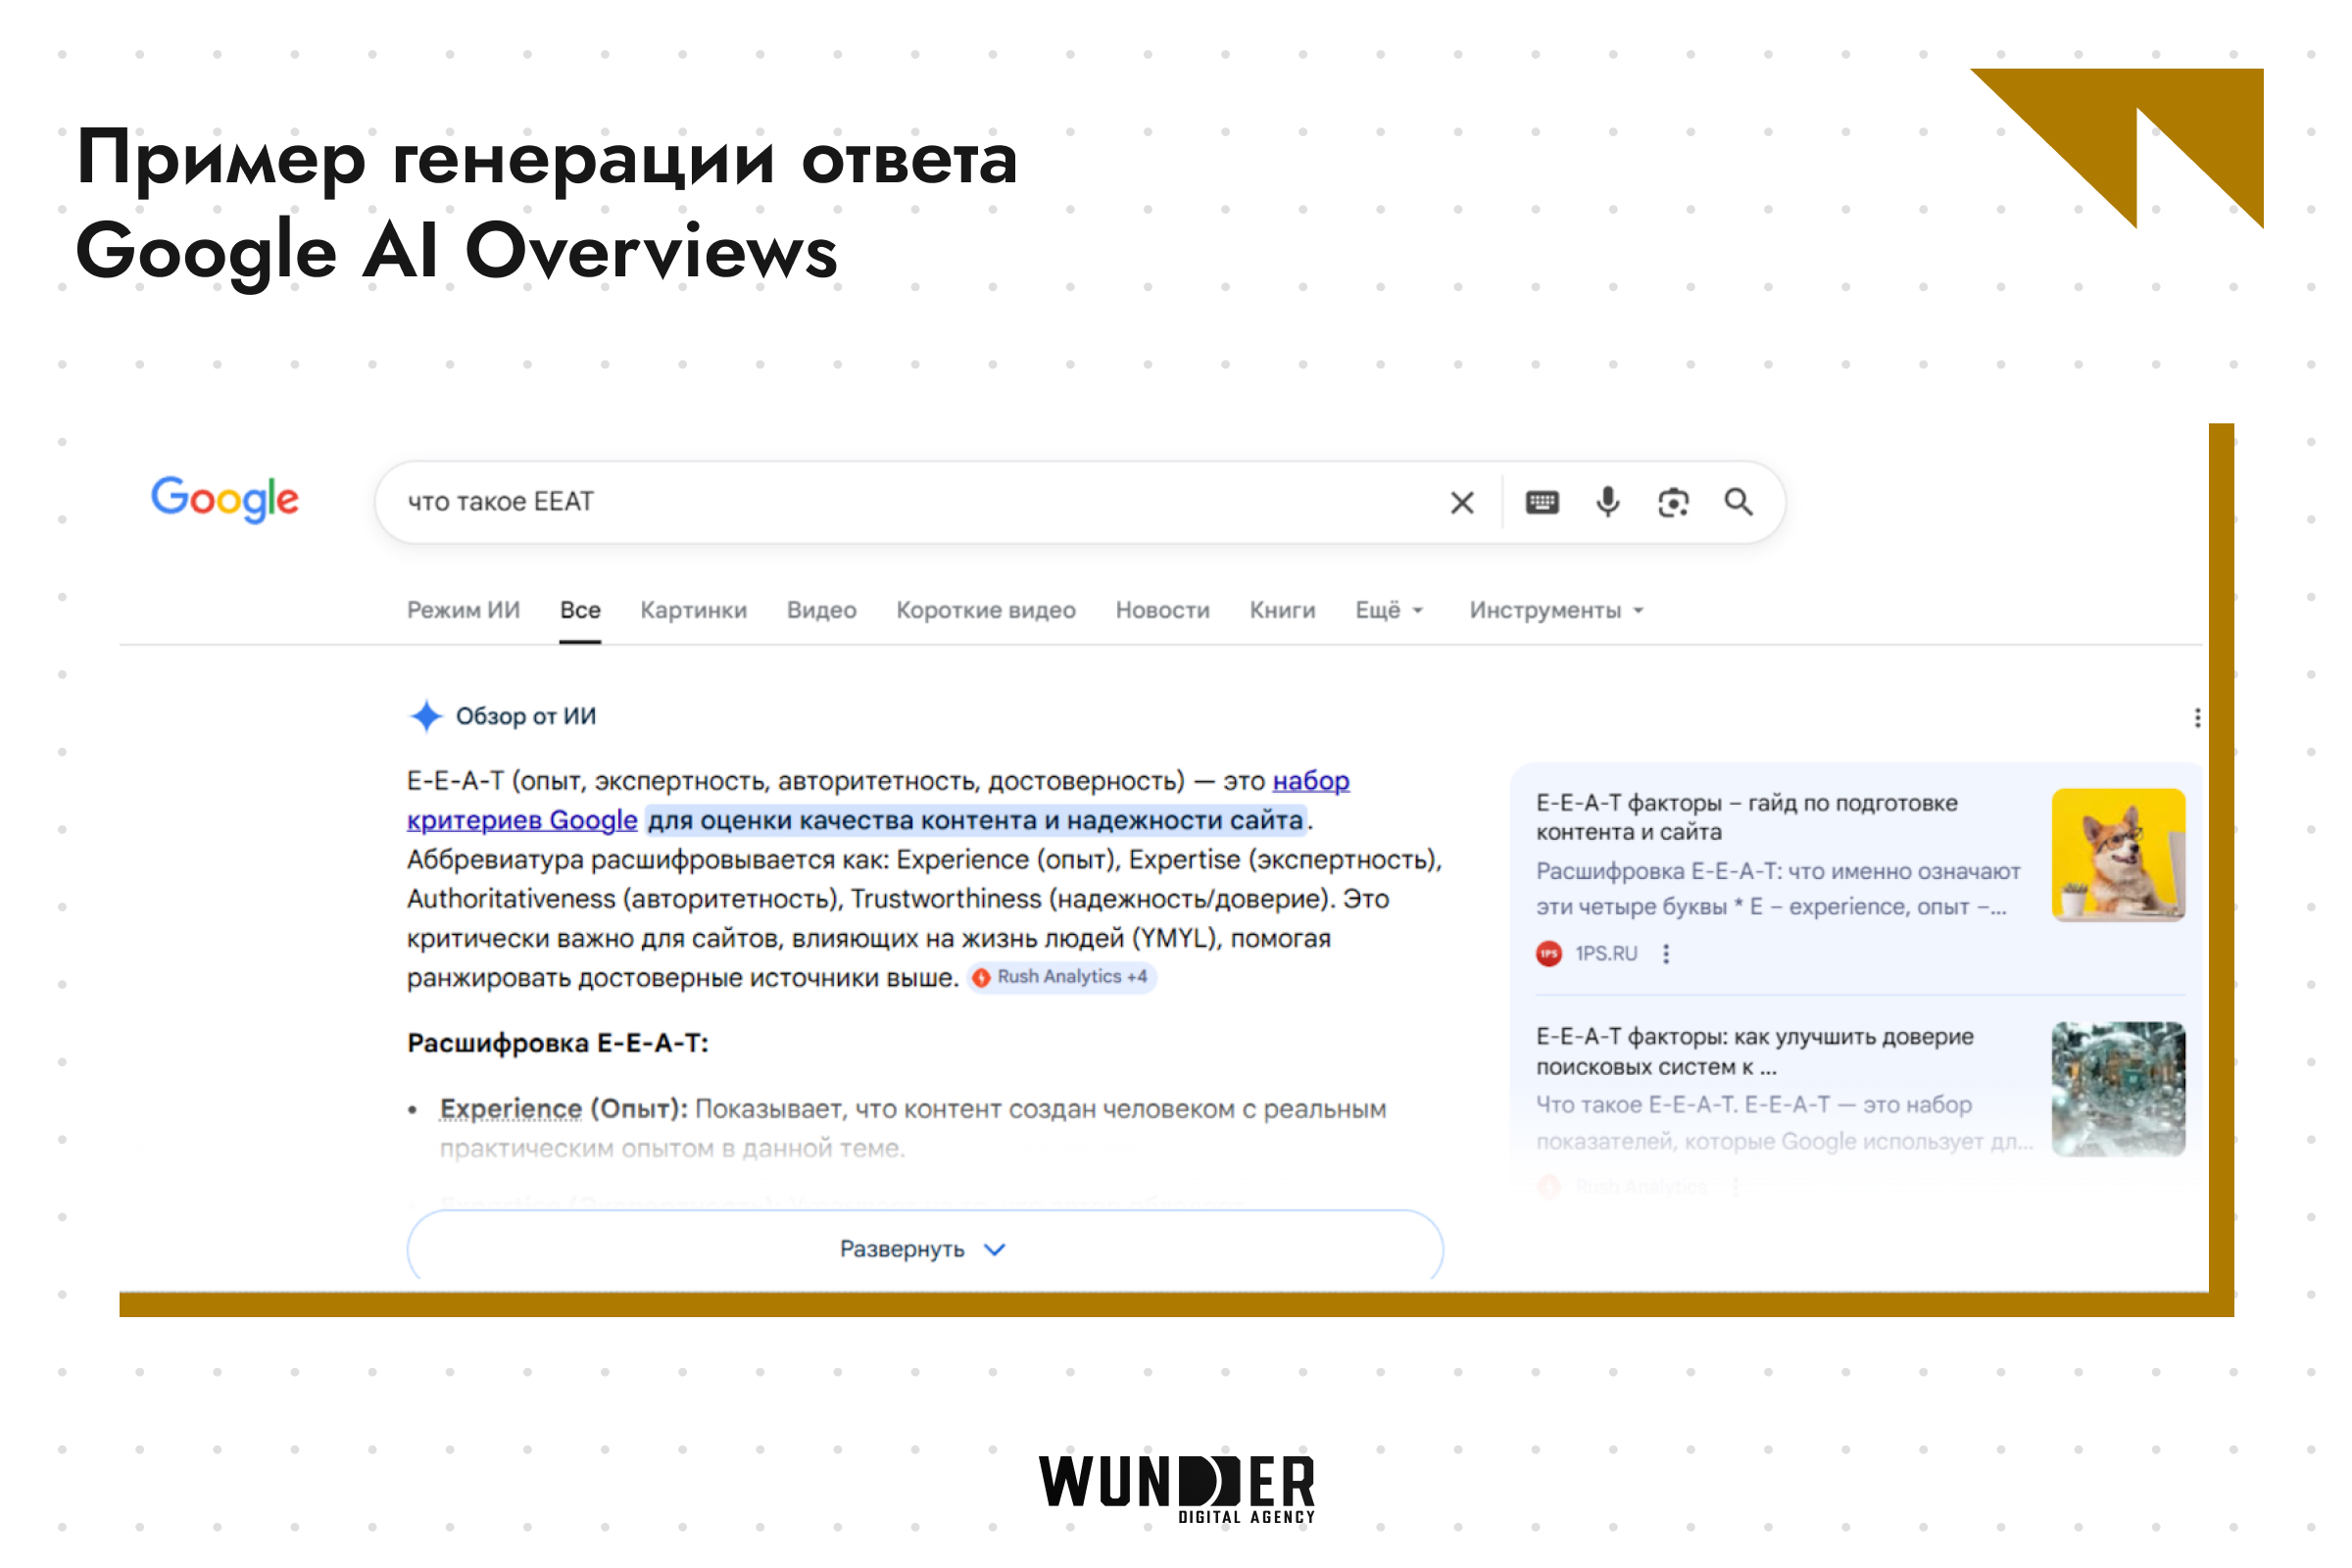
AI Overviews, ранее называвшийся SGE, напрямую использует индекс Google. В этом отличие генеративного поиска от чат-моделей. Языковая модель составляет окончательный ответ и соотносит его с найденными публикациями.
Материалы для цитирования отбираются там же, где и для обычной выдачи: в органическом индексе Google. Кандидатов ищут по самому запросу и связанным с ним подвопросам. При fan-out сложный вопрос разделяют на подтемы и для каждой находят подходящие документы.
Как подтверждает Google, сигналы качества для AI Overviews совпадают с используемыми в классическом поиске. К ним добавляется извлекаемость: сможет ли система без труда выделить на странице определенный факт.
Почему AI Overviews цитирует одни сайты, а другие пропускает
- Точное раскрытие темы. Страница должна исчерпывающе объяснять конкретный подвопрос и соответствовать его содержанию.
- Подтвержденная авторитетность. E-E-A-T выражается в экспертизе авторов, пользе и оригинальности контента, качестве внешних ссылок, силе домена и репутации бренда.
- Сведения, которые не устарели. Если тема быстро меняется, обновления дают преимущество. Это касается новостей, обзоров и информации о ценах.
- Факты, которые легко выделить. Ясные заголовки, прямые ответы, FAQ, списки и таблицы упрощают извлечение нужных сведений для генеративного блока.
- Разные площадки. Google старается подкрепить ответ материалами более одного сайта, представляя разные домены.
По данным исследований, большинство цитируемых AI Overviews страниц находится среди первых 10 результатов обычного поиска по тому же или близкому запросу.
Этапы подготовки ответа по найденным материалам
- Модель определяет, как построить ответ с учетом заданного вопроса.
- Из индекса отбираются документы, соответствующие запросу: используются retrieval и semantic ranking.
- Данные из найденных публикаций соединяются со знаниями модели, полученными при предобучении.
- Для каждого фрагмента выбирают 1-3 источника, наиболее точно подтверждающих его тезис, и добавляют ссылки на них.
По ссылке в ответе можно открыть первоисточник. Ее помещают возле абзаца или под ним.
Как попасть в ответы ИИ? Направления работы с сайтом
По наблюдениям специалистов и рекомендациям вебмастерам, шансы стать источником для AI Overviews повышают такие действия:
- опираться на семантику и учитывать, какую задачу человек хочет решить своим запросом;
- подкреплять E-E-A-T авторством, брендом и сильным ссылочным профилем, ясно указывать источники;
- делать факты удобными для извлечения за счет таблиц, списков, FAQ и подачи в формате «вопрос — ответ» (Q&A);
- добавлять разметку структурированных данных: Person, Organization, Article, HowTo, FAQ;
- регулярно пересматривать публикации, для которых важна свежесть информации.
Из чего складывается доверие: E-E-A-T и Brand Authority
И чат-модели, и AI Overviews заинтересованы в достоверном ответе. Его качество выше, а риск дезинформации ниже, когда материалы демонстрируют опыт, компетентность, авторитет и надежность.
E-E-A-T не сводится к одному показателю ни в одной системе. Каждое качество определяется по косвенным признакам:
Experience — опыт. Его показывают конкретные примеры, практические кейсы и подтверждение того, что автор работал с темой.
Expertise — экспертиза. На компетентность указывают глубина разбора, корректное употребление терминов, обращение к исследованиям и первоисточникам.
Authority — авторитет. Его показывают репутация домена, присутствие бренда на других площадках и профиль внешних ссылок.
Trust — доверие. Фактические сведения должны быть точными и не противоречить друг другу, а происхождение информации — понятным.
Общая цель — оценить, заслуживает ли публикация доверия. Однако значимость отдельных признаков различается: цитирование сайта нейросетями и ранжирование в Google зависят от разных сочетаний сигналов.
Елена Салтыкова:
— Brand Authority важен и для LLM. Он отражает частоту упоминаний бренда в профильных дискуссиях, медиа, исследованиях и обзорах. Чем больше таких упоминаний на разных ресурсах, тем вероятнее, что модель будет доверять информации этого бренда.
Google: роль поискового индекса и сторонних сигналов
Чтобы оценить E-E-A-T в Google, учитывают в совокупности:
- насколько качественно подготовлен контент;
- из каких внешних ссылок складывается профиль сайта;
- как ведут себя пользователи;
- как бренд представлен в поисковых запросах;
- какой репутацией обладает домен.
Поэтому хорошая SEO-подготовка часто дает сайту преимущество при ранжировании.
LLM: насколько понятно организован материал
Для языковых моделей больший вес получает подача самого материала. Значение имеют:
- понятное деление на смысловые части;
- связное и последовательное изложение;
- разбор, который исчерпывает вопрос;
- прямые указания на использованные источники в виде ссылок;
- контекст, раскрывающий автора публикации или бренд.
Подача должна позволять модели улавливать смысл написанного и извлекать фактические сведения.
Елена Салтыкова:
— Развитие E-E-A-T почти всегда повышает вероятность успешного ранжирования в Google и ссылки на сайт из AI-ответа. Общий эффект не означает, что алгоритмы устроены одинаково.
Почему сайт не попадает в AI, даже если контент качественный

Даже хорошая площадка может не стать источником ответа. Разбирая, почему AI не цитирует сайт, стоит проверить пять распространенных недочетов.
- Суть теряется в объеме. Нет короткого ответа на сам вопрос, а нужные сведения растворены в затянутом вступлении и сплошном тексте. Из-за этого нейросети труднее выделять факты.
- Не выстроена структура. Редко используются FAQ и подзаголовки, списки и таблицы. Возможна и техническая проблема: Schema.org-разметку не добавили либо настроили с ошибками.
- Нет дополнительных сведений. Публикация пересказывает материалы конкурентов, но не дополняет их исследованиями, кейсами или данными. Поэтому система не получает оснований выбрать ее.
- Не совпадает назначение страницы. Она продает, хотя пользователь и AI ищут инструкцию, чек-лист или объяснение. Получается расхождение с интентом запроса.
- Мало оснований для доверия. Компания почти не упоминается за пределами своего ресурса, авторство непрозрачно. Дополнительно ослабляет доверие отсутствие ссылок на авторитетные источники.
AI-контент: по каким признакам судят о качестве
Качество нейросеть оценивает по паттернам текста. Само происхождение не определяет, отнесут ли материал к AI-контенту. Слабую публикацию выдают:
- слишком предсказуемое построение фраз;
- повторы и конструкции, собранные по одному шаблону;
- малое количество информации при большом объеме;
- отсутствие конкретики, числовых данных и фактов;
- неизменные тональность и ритм изложения.
Елена Салтыкова:
— Общие слова, за которыми нет новых сведений, делают текст низкокачественным. Оценка не изменится от того, писал его человек или ИИ.
Сам факт использования AI не является проблемой. Проблема возникает, когда публикации не хватает содержания, оригинальности и пользы.
Видимость сайта в AI-поиске: два направления работы
Качественный контент остается основой, на которую опирается AI-поиск. Google и чат-модели стремятся выбирать надежные источники с экспертизой и авторитетом. Однако способы распознать эти свойства у систем разные.
Для языковой модели существенны ясное, исчерпывающее объяснение и удобство извлечения фактов. Google сильнее зависит от SEO: устройства ресурса, характеристик ссылочного профиля, поведенческих сигналов и авторитета домена.
Поэтому нужна работа сразу в двух направлениях:
- укреплять авторитет бренда и развивать SEO;
- готовить содержательные материалы с понятной структурой, из которых удобно извлекать ответы.
Преимущество получают сайты, которые не ограничиваются оптимизацией под алгоритмы и становятся источниками знаний по своей теме.